テーマ
第4章 機械学習入門 — データから学ぶとはどういうことか
この章で学ぶこと
- 「ルールを人が書く」プログラミングと「データから機械が学ぶ」機械学習の違い
- モデルとは「パラメータ付きの関数
- 損失関数 — 「どれくらい外しているか」を1つの数値にする仕組み
- 勾配降下法 — 損失の谷を一歩ずつ下ってパラメータを改善する方法(具体的な数値で手計算します)
- 学習率
- 訓練データとテストデータ、過学習と汎化
- 分類問題では「確率分布」を出力するという考え方
- 「特徴量を人が設計する時代」から「表現も学習する深層学習」への流れ
この章の前提
- 第1章 数学の準備(1)— 関数と記号に慣れる — 関数
- 第2章 数学の準備(2)— ベクトルと行列 — ベクトルという「数の並び」
- 第3章 数学の準備(3)— 微分・勾配・確率 — 微分 = 傾き、勾配
ここまでの3章で揃えた道具が、この章からいよいよ実戦投入されます。特に第3章の「勾配はいちばん急な上り方向。マイナスを付ければ下り方向」という話は、この章の主役です。
4.1 ルールを人が書く vs データから機械が学ぶ
4.1.1 従来のプログラミング: ルールは人間が書く
コンピュータに何かをさせる伝統的な方法は、人間が手順(ルール)をすべて書き下すことです。たとえば「消費税込みの価格を計算する」なら、「入力された価格に 1.1 を掛けて出力せよ」というルールを人間が考え、機械はそれを忠実に実行します。第1章の言葉で言えば、人間が関数
これは、ルールが明確に書き下せる問題では完璧に機能します。ところが世の中には、人間はできるのに、ルールとして書き下せない仕事がたくさんあります。
- 写真を見て「これは猫だ」と判定する
- 手書きの文字を読む
- 「猫は魚が好き」の次に来そうな言葉を予想する
あなたは猫の写真を一瞬で見分けられますが、「耳が三角で、ヒゲがあって……」とルールを書き始めると、すぐに破綻します。後ろ向きの猫は? 毛布に包まった猫は? 例外に次ぐ例外で、ルールは無限に増えていきます。
4.1.2 機械学習: ルールをデータから見つけさせる
そこで発想を逆転させます。ルールを書くのをあきらめて、大量の実例(データ)を見せて、ルールに相当するものを機械自身に見つけさせるのです。これが機械学習(machine learning) です。
| 従来のプログラミング | 機械学習 | |
|---|---|---|
| 人間が用意するもの | ルール(手順) | データ(実例)と「学び方の枠組み」 |
| 機械がやること | ルールを実行する | データに合うルールを探し出す |
| 得意な問題 | 手順が明確な問題 | 手順を書き下せないが実例は豊富な問題 |
| 例 | 税込価格の計算 | 猫の画像認識、次の単語の予測 |
flowchart TD
    subgraph 従来のプログラミング
        A["人間がルールを書く"] --> B["機械がルールを実行"]
        B --> C["答え"]
    end
    subgraph 機械学習
        D["人間がデータを集める"] --> E["機械がデータからルールを探す"]
        E --> F["見つけたルールで答えを出す"]
    end
本書の主役であるTransformerも、この機械学習の産物です。「言葉のルール」を誰かが書いたのではなく、大量の文章データから機械が見つけ出したのです。では、「機械がルールを探す」とは具体的に何をすることなのでしょうか。それがこの章の残り全部のテーマです。
4.2 モデル = パラメータ付きの関数
4.2.1 「調整つまみ付きの関数」を用意する
機械学習では、まずモデル(model) と呼ばれるものを用意します。モデルの正体は、第1章で学んだ「関数」です。ただし普通の関数と違って、調整可能なつまみ(数値)が付いた関数です。このつまみのことをパラメータ(parameter) と呼びます。
パラメータをまとめて
読み下し: 「入力
たとえば一次関数
読み下し: 「入力
同じ「一次関数」という枠組みでも、つまみの設定次第でまったく違う関数になる。これがモデルです。
4.2.2 学習 = 良いパラメータ探し
ここが機械学習の核心です。
IMPORTANT
学習とは、手元のデータに最もよく合うパラメータ
関数の「形の枠組み」(一次関数にするか、もっと複雑な形にするか)は人間が決めます。しかし、つまみの値そのものはデータに決めさせる。これが「データから学ぶ」の正体です。
ちなみに、本書の最終目的地であるLLM(大規模言語モデル)も、まったく同じ枠組みの上にあります。違いはつまみの数だけです。この章の例ではつまみは2個ですが、LLMではつまみが数十億〜数兆個あります。「学習=良いパラメータ探し」という原理は、つまみが2個でも2兆個でも変わりません。
4.3 例: 一次関数をデータに当てはめる
具体例で考えましょう。あなたが引っ越し先を探していて、「部屋の広さから家賃を予測したい」とします。
不動産サイトで集めたデータがこうだったとします。
| 部屋の広さ | 家賃 |
|---|---|
| 20 | 8.1 |
| 25 | 9.0 |
| 30 | 10.2 |
| 40 | 11.8 |
| 50 | 14.1 |
このデータを眺めると、「広いほど高い」というおおまかな傾向が見えます。そこで、モデルとして一次関数を選びます。
読み下し: 「広さ
グラフで見ると、やりたいことはこうです。
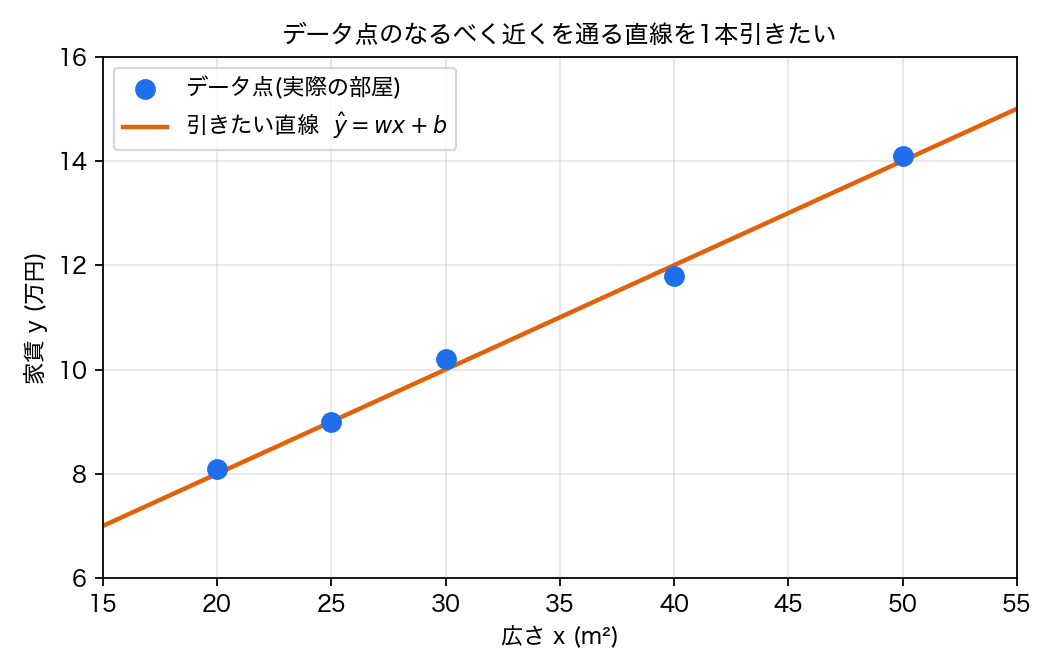
(図: 青い点が5件のデータ、オレンジの直線がモデル
ばらばらに散らばったデータ点のなるべく近くを通る直線を1本引きたい。直線は
では「良い」とは何でしょうか。感覚的には「どの点からも大きく外れていない」ことですが、機械に探させるには、「良さ」を数値で測れるようにしなければなりません。そこで登場するのが損失関数です。
4.4 損失関数 — 「どれくらい外しているか」の点数
4.4.1 外れ具合を1つの数値にする
損失関数(loss function)
最も基本的な損失関数が二乗誤差(squared error) です。データが
読み下し: 「
4.4.2 なぜ「2乗」するのか
単純に差
- プラスとマイナスの外れが打ち消し合うのを防ぐ。 1万円高く予測した部屋と1万円安く予測した部屋があると、単純な差の合計は
- 大きな外れを重く罰することができる。 2万円の外れは、2乗すると
- 滑らかな曲線になり、微分(傾きの計算)ができる。 符号をプラスにするだけなら絶対値
4.4.3 数値例: 損失を実際に計算する
手計算しやすいように、この節からはデータを思い切り単純にします。データは2点だけ、モデルはバイアスを省いた
| データ番号 | 入力 | 正解 |
|---|---|---|
| 1 | 1 | 2 |
| 2 | 2 | 4 |
(勘の良い方は「
損失関数は、後の微分計算をきれいにするため、慣習に従って
読み下し: 「各データについて、予測
いくつかの
xychart-beta
    title "損失の谷 L(w)"
    x-axis "w" [0, 0.5, 1, 1.5, 2, 2.5, 3, 3.5, 4]
    y-axis "L(w)" 0 --> 10
    line [10, 5.625, 2.5, 0.625, 0, 0.625, 2.5, 5.625, 10]
谷底は
第3章で「傾きが0の場所が谷底(最小値)」と学びました。学習のゴールは、この損失の谷の底を見つけることです。
IMPORTANT
学習 = 損失関数
今回のような単純な例なら、グラフを描けば谷底は目で見えます。しかしパラメータが2個になると損失は「地形(曲面)」になり、100万個になれば100万次元の地形です。グラフはもう描けません。目で見ずに谷底へたどり着く方法が必要です。それが勾配降下法です。
4.5 勾配降下法 — 霧の中で谷を下る
4.5.1 発想: 足元の傾きだけを頼りに下る
こんな状況を想像してください。あなたは深い霧の山中に立っていて、谷底の山小屋に行きたい。周りはまったく見えませんが、足元の地面がどちらに傾いているかだけは分かります。どうしますか?
素直な作戦はこうです。
- 足元の傾きを調べる
- いちばん急な下り方向に一歩進む
- そこでまた傾きを調べ、また一歩進む。これを繰り返す
これをそのまま数式にしたのが勾配降下法(gradient descent) です。第3章で学んだとおり、勾配
読み下し: 「現在のパラメータ
パラメータが
読み下し: 「いまの
傾きの符号に注目すると、この式のうまさが見えてきます。
- 谷底より左にいるとき: 傾きはマイナス(下り坂)。マイナスを引く = 足す。つまり
- 谷底より右にいるとき: 傾きはプラス(上り坂)。プラスを引く。つまり
- 谷底では: 傾きは
どこにいても谷底に向かい、谷底に着けば止まる。しかも坂が急な(=大きく外している)ほど一歩が大きく、谷底に近づいて坂が緩やかになるほど一歩が小さくなる。実によくできた仕組みです。
4.5.2 学習ループの全体像(本章の最重要図)
学習の全体は「予測 → 採点 → 傾き計算 → 更新」のループです。この図は本書全体で何度も戻ってくる最重要の図です(第10章でTransformerを訓練するときも、ループの中身が豪華になるだけで骨格はこのままです)。
flowchart TD
    A["パラメータを適当な値で初期化"] --> B["予測: モデルにデータを入れて予測値を出す"]
    B --> C["採点: 損失関数で外れ具合を数値化"]
    C --> D["傾き: 損失の勾配を計算"]
    D --> E["更新: 勾配の逆方向へ一歩進む"]
    E --> F{"損失は十分小さい?"}
    F -- "まだ大きい" --> B
    F -- "十分小さい" --> G["学習完了"]
4.6 手計算でやってみる — 勾配降下法を2〜3ステップ
いよいよ、この章のハイライトです。4.4.3節のデータ(2点:
4.6.1 準備: 傾きの式を求める
損失は
読み下し: 「データ1の外れ
これを
読み下し: 「各データについて『外れ幅 × 入力』を計算して足し合わせたものが傾きになる」。整理すると、
読み下し: 「この問題では、傾きは
4.6.2 いざ、谷下り(学習率
スタート地点は
ステップ1
- 現在地:
- 傾き:
- 更新:
読み下し: 「いまの
ステップ2
- 現在地:
- 傾き:
- 更新:
読み下し: 「
ステップ3
- 現在地:
- 傾き:
- 更新:
読み下し: 「
4.6.3 結果のまとめ
| ステップ | 損失 | 傾き | 更新量 | 更新後の | |
|---|---|---|---|---|---|
| 1 | 0 | 10 | 1.0 | ||
| 2 | 1.0 | 2.5 | 1.5 | ||
| 3 | 1.5 | 0.625 | 1.75 | ||
| 4 | 1.75 | 0.15625 | 1.875 | ||
| … | … | … | … | … | … |
| ∞ | 2.0 | 0 | 0 | 0 | 2.0 |
損失が
xychart-beta
    title "勾配降下法の軌跡: 損失はステップごとに約4分の1へ"
    x-axis "ステップ" [0, 1, 2, 3, 4]
    y-axis "損失 L" 0 --> 10
    line [10, 2.5, 0.625, 0.156, 0.039]
(図: 上の表の損失の値をグラフにしたもの。序盤は急坂(傾きが大きい)なので一歩が大きく損失が一気に減り、谷底
これが機械学習の「学習」の正体です。特別な仕掛けはなく、「外れ具合を測る → 傾きを計算する → 傾きと逆に少し動かす」をひたすら繰り返すだけです。LLMの訓練も、パラメータが数千億個になり損失関数が複雑になるだけで、やっていることはこの表と同じです。
4.7 学習率
さきほど
4.7.1 小さすぎる場合(
- ステップ1:
- ステップ2:
- ステップ3:
進んではいますが、亀の歩みです。谷底の
4.7.2 大きすぎる場合(
- ステップ1:
- ステップ2: 傾きは
- ステップ3: 傾きは
損失で見ると
ちなみに中間の
3つの場合について、パラメータ
- 緑色の水平な直線 = 目指している正解の値(
- もう1本の折れ線 = 各ステップでの
xychart-beta
    title "(1) ηが適切 0.1: するすると正解の w=2 に近づく"
    x-axis "ステップ" [0, 1, 2, 3, 4]
    y-axis "パラメータ w の位置" 0 --> 2.5
    line [0, 1, 1.5, 1.75, 1.875]
    line [2, 2, 2, 2, 2]
xychart-beta
    title "(2) ηが大きすぎ 0.5: 正解の w=2 を毎回通り過ぎ、振れ幅が拡大して発散"
    x-axis "ステップ" [0, 1, 2, 3, 4]
    y-axis "パラメータ w の位置" -10 --> 10
    line [0, 5, -2.5, 8.75, -8.13]
    line [2, 2, 2, 2, 2]
xychart-beta
    title "(3) ηが小さすぎ 0.01: 方向は正しいが、正解の w=2 には遠く届かない"
    x-axis "ステップ" [0, 1, 2, 3, 4]
    y-axis "パラメータ w の位置" 0 --> 2.5
    line [0, 0.1, 0.2, 0.29, 0.37]
    line [2, 2, 2, 2, 2]
(図: 同じスタート地点
| 学習率 | 何が起こるか | たとえ |
|---|---|---|
| 小さすぎる | 収束が非常に遅い | すり足で山を下りる |
| ちょうど良い | 効率よく谷底へ | 適切な歩幅でスタスタ下る |
| 大きすぎる | 谷を飛び越えて振動・発散 | 全力ジャンプで谷の反対側の壁に激突 |
適切な学習率は問題ごとに違い、機械学習の実務では最も重要な「調整項目」の1つです。第10章では、Transformerの訓練でこの歩幅を自動調整する工夫(Adamや学習率ウォームアップ)が登場します。
4.8 パラメータが2個以上のとき — 勾配ベクトルの出番
ここまで、つまみは
損失の「地形」は、
読み下し: 「
更新式
偏微分の式は(4.6.1節と同じ要領で)、
読み下し: 「
- 勾配:
- 更新:
損失は
パラメータが100万個でも1兆個でも、話はまったく同じです。勾配ベクトルの成分が100万個・1兆個に増えるだけで、「全つまみの傾きを一斉に計算し、全つまみを一斉に少し動かす」という手順は変わりません。「そんな膨大な傾きをどうやって効率よく計算するのか?」という当然の疑問には、第5章の逆伝播が答えます。
4.9 訓練データとテストデータ — 丸暗記では意味がない
4.9.1 本当に測りたいのは「初見の問題」への強さ
ここまでの話には、実は落とし穴があります。損失を小さくすること自体が目的化すると、おかしなことが起こるのです。
学校のテストにたとえましょう。問題集(過去問)を勉強して、本番の試験に臨むとします。
- 問題集の答えを丸暗記した生徒: 問題集と同じ問題なら100点。しかし本番で少しひねられると全滅。
- 問題集から解き方を理解した生徒: 問題集では95点かもしれないが、本番の初見問題にも対応できる。
私たちがモデルに求めるのは後者です。学習に使ったデータで良い成績を取ることではなく、まだ見たことのないデータで良い予測をすること。この「初見への強さ」を汎化(generalization) と呼びます。
4.9.2 データを2つに分ける
汎化できているかを測る標準的な方法は、手持ちのデータをあらかじめ2つに分けておくことです。
- 訓練データ(training data): 学習(パラメータ調整)に使う。問題集に相当。
- テストデータ(test data): 学習には一切使わず、最後に成績測定だけに使う。本番の試験に相当。
flowchart TD
    A["手持ちの全データ"] --> B["訓練データ(例: 8割)"]
    A --> C["テストデータ(例: 2割)"]
    B --> D["学習: パラメータを調整"]
    D --> E["学習済みモデル"]
    C --> F["評価: 初見データでの損失を測る"]
    E --> F
4.9.3 過学習 — 丸暗記に陥ったモデル
訓練データでの損失は小さいのに、テストデータでの損失が大きい状態を過学習(overfitting) と呼びます。モデルが訓練データを「丸暗記」してしまい、データに混じった偶然のノイズまで律儀に再現している状態です。
家賃の例で言えば、5件のデータ点すべてを完璧に通るぐにゃぐにゃの曲線(つまみの多い複雑なモデル)を引くことは可能です。訓練データでの損失はゼロ。しかしそのぐにゃぐにゃは、「たまたまこの5件がそうだった」という偶然に過剰に付き合った結果であり、6件目の部屋の家賃予測はむしろ下手になります。
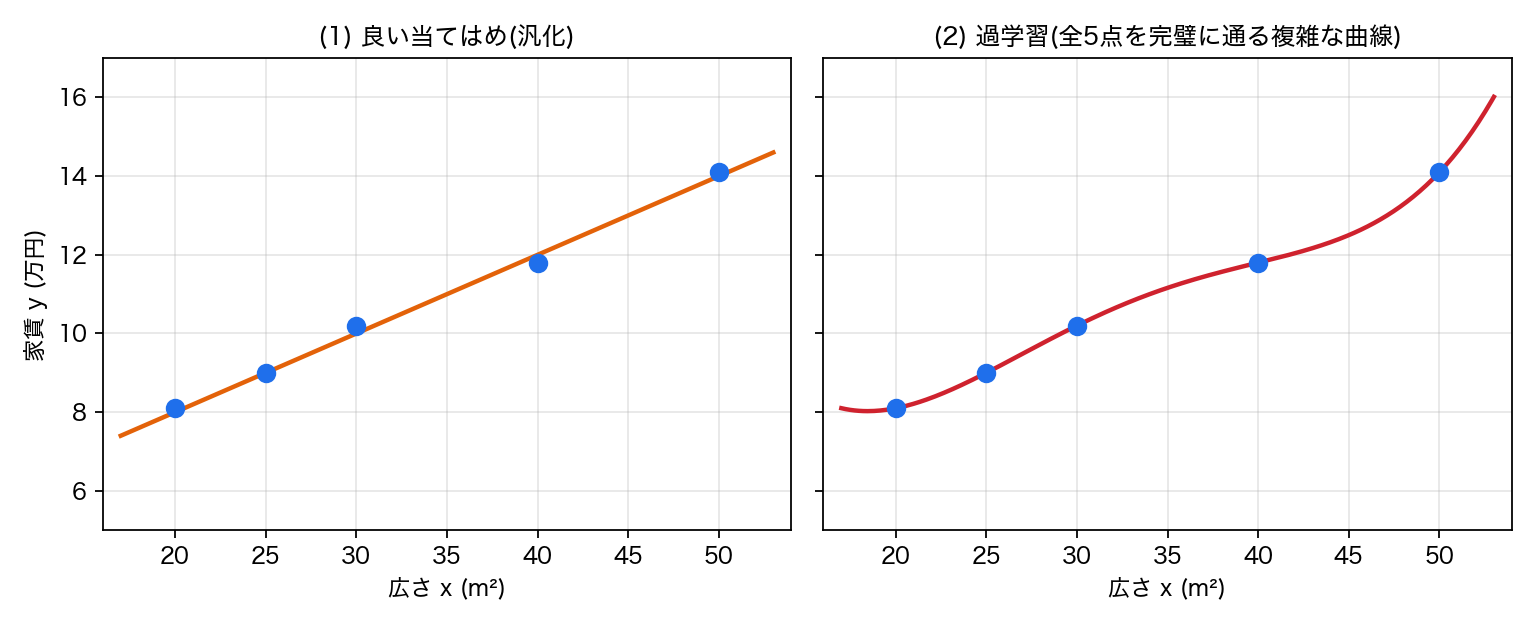
(図: 左は直線で全体の傾向をとらえた状態で、初見のデータも直線の近くに来ることが期待できる。右は5点すべてを完璧に通る複雑な曲線で、訓練データでの損失はゼロだが、点の間や範囲の外では予測が当てにならない)
逆に、モデルが単純すぎて訓練データすらろくに合わせられない状態は未学習(underfitting) と呼びます。ちょうど良い複雑さのモデルを、ちょうど良い加減まで学習させることが大切です。
この「大きすぎるモデルは過学習する」という常識は、機械学習の基本中の基本です。……なのですが、実は本書の後半(第13章)で、LLMではこの常識が成り立たなくなる話が出てきます。楽しみにしていてください。
4.10 分類問題 — 答えを「確率分布」で出す
4.10.1 回帰と分類
ここまでの家賃予測のように、数値を当てる問題を回帰(regression) と呼びます。一方、いくつかの選択肢のどれかを当てる問題を分類(classification) と呼びます。
- この写真は「猫・犬・魚」のどれか? (3択の分類)
- このメールは「迷惑メール・普通のメール」のどちらか? (2択の分類)
- 「猫は魚が」の次に来る単語は語彙5万語のうちどれか? (5万択の分類!)
最後の例に注目してください。本書の主役である言語モデルの「次の単語を当てる」仕事は、巨大な分類問題なのです。だから分類の仕組みを押さえることは、そのままTransformer理解の土台になります。
4.10.2 白黒つけずに、自信の度合いを出す
分類モデルの出力はどんな形が良いでしょうか。「猫です」と1つだけ答えさせる(白黒つける)こともできますが、それより各選択肢にどれくらい自信があるかを丸ごと出させるほうがずっと便利です。たとえば「この写真は…… 猫: 70%、犬: 25%、魚: 5%」のように答えさせるのです。
これはまさに、第3章で学んだ確率分布です(すべて0以上で、合計が1)。第3章の最後に「『文の次に来る単語』は確率分布と見なせる」という話をしました — 「猫は魚が」の次は「好き: 50%、食べ: 20%、大好き: 15%、……」。分類モデルの出力を確率分布にするというのは、あの見方をそのまま実装することなのです。
xychart-beta
    title "「猫は魚が ___」の次の単語の予測(確率分布のイメージ)"
    x-axis ["好き", "食べ", "大好き", "嫌い"]
    y-axis "確率" 0 --> 0.6
    bar [0.50, 0.20, 0.15, 0.10]
図に載せた4語以外の残りの単語には 0.05 が薄く分配されており、全体の合計はきっちり1になります(第3章3.9.1節の表と同じ分布です)。
ただし、モデルの計算(掛けて足す)の生の結果は、マイナスになったり合計が1にならなかったりする「ただの数値の並び」です。これを確率分布の条件(全部0以上・合計1)に整える専用の変換が必要で、それがsoftmax(ソフトマックス) です。softmaxは本書でも特に大事な関数なので、次の第5章でじっくり導入します。ここでは「生の点数を確率分布に変換する関数が要る」とだけ覚えておいてください。
また、分類問題では損失関数も二乗誤差ではなく、確率分布向けの交差エントロピーというものを使います。これも第5章で登場します。
4.11 特徴量を人が設計する時代から、深層学習へ
最後に、この章と次章をつなぐ歴史の話をします。
4.11.1 入力を「数の並び」にするのは誰の仕事か
家賃の例では、入力は「広さ」という1つの数でした。しかし現実の入力はもっと複雑です。「この部屋の家賃」を本気で予測するなら、広さ・駅からの距離・築年数・階数……と、入力は第2章で学んだベクトル(数の並び)になります。
読み下し: 「入力ベクトル
長い間、機械学習の成否は「良い特徴量を人間が設計できるか」で決まっていました。家賃なら特徴量は考えやすい。しかし、猫の写真の特徴量は? 「猫らしさ」を数値の並びで表す方法を人間が設計するのは絶望的に難しく、これが4.1節の「ルールを書き下せない問題」の正体でもありました。写真から「耳の尖り具合」を数値化するルール自体が書けないのです。
4.11.2 深層学習: 特徴量まで機械に学ばせる
そこで再び発想の転換が起こります。「特徴量の設計も、機械に学ばせてしまえばいいのでは?」というわけです。
生のデータ(画像なら画素の値、文章なら単語の列)をそのまま入れて、「そこから何に注目すべきか(=良い特徴量、良い表現)」自体をパラメータとして学習させる。これを可能にしたのが、関数を何層にも重ねたニューラルネットワークであり、それを深く積んだ深層学習(deep learning) です。
| 従来の機械学習 | 深層学習 | |
|---|---|---|
| 特徴量(表現) | 人間が設計 | 機械が学習 |
| 人間の仕事 | 「何に注目すべきか」を考える | データと計算資源を用意する |
| 例 | 広さ・築年数から家賃予測 | 画素から猫認識、単語列から次単語予測 |
この章で学んだ道具立て — モデル
この章のまとめ
- 機械学習は、ルールを人が書く代わりに、データからルールに相当するものを機械に探させる方法である
- モデルとはパラメータ
- 損失関数
- 勾配降下法
- 学習率
- データは訓練データとテストデータに分け、初見データへの強さ(汎化)を測る。訓練データの丸暗記は過学習
- 分類問題の出力は確率分布にするのが良い。「次の単語の予測」は巨大な分類問題である(生の点数を確率分布にする関数 = softmax は次章)
- 特徴量を人が設計する時代から、表現そのものを学習する深層学習の時代へ — その主役がニューラルネットワーク
次の章へ
次章では、いよいよニューラルネットワークの中身を開けます。1個の人工ニューロンが第2章の「内積」そのものであること、層を重ねることが第1章の「関数の合成」であることを確かめ、そして本書の後半で繰り返し使う softmax と交差エントロピーを手計算で身につけます。